Sitemap XML e Robots.txt: La Guida che Avrei Voluto Leggere all'Inizio
Quando lanciamo un nuovo sito web, spesso passiamo ore a perfezionare le animazioni CSS, a ottimizzare le immagini e a limare il copy. Poi, pubblichiamo il sito e ci dimentichiamo di due microscopici file di testo che dettano legge su come Google interagirà con il nostro lavoro: il robots.txt e la sitemap.xml.
All’inizio della mia carriera, configuravo questi file un po’ per inerzia, copiando e incollando da vecchi progetti. È un errore che commettono molti sviluppatori. Capire esattamente come funzionano non è solo un “plus”, ma la base assoluta della Technical SEO - lo stesso principio che guida ogni scelta che racconto nella mia guida ai Core Web Vitals 2026.
Ecco la guida pratica e senza fronzoli che avrei voluto leggere io anni fa.
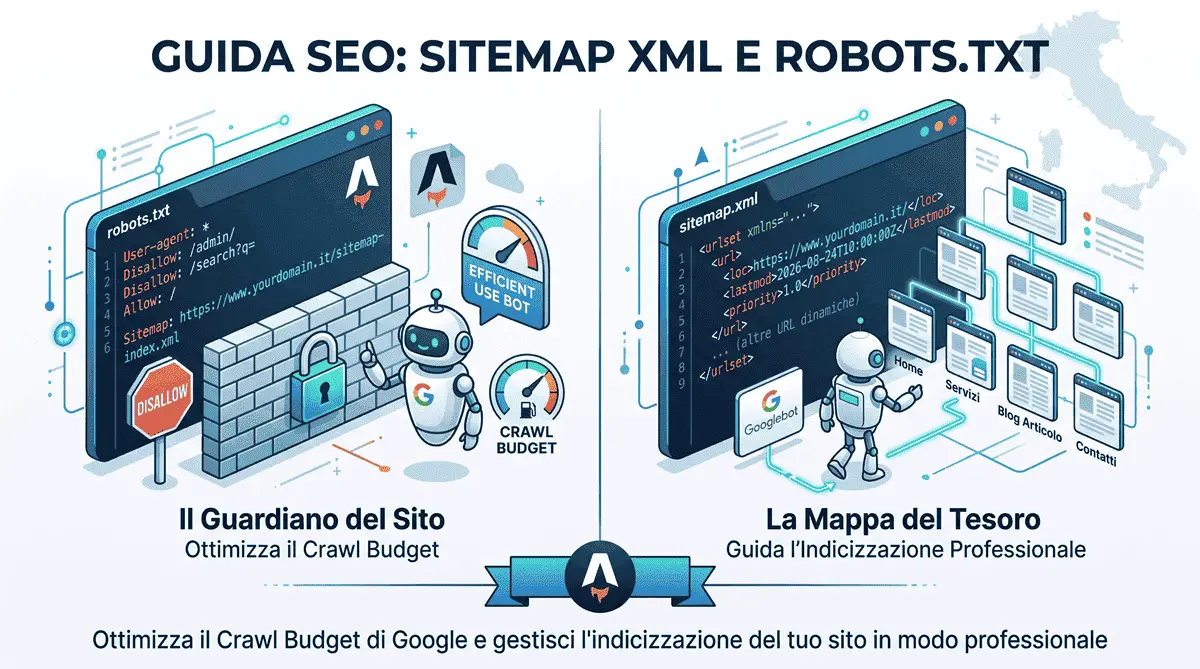
1. Robots.txt: Il Guardiano del Sito
Il file robots.txt si trova sempre nella directory principale del tuo sito (tuosito.com/robots.txt). È la prima cosa che i crawler (come Googlebot) guardano quando arrivano. Le sue istruzioni dicono ai bot quali stanze della tua casa possono visitare e quali porte devono restare chiuse.
La Sintassi Base
Le direttive funzionano tramite due comandi principali: User-agent (a quale bot ti rivolgi) e Disallow (cosa non può scansionare).
User-agent: *
Disallow: /admin/
Disallow: /ricerca?q=
Allow: /
Nello script qui sopra stiamo dicendo a tutti i bot (*) di non scansionare la cartella di amministrazione e di non scansionare le pagine dei risultati di ricerca interna (per evitare di sprecare Crawl Budget su pagine di scarso valore).
L’Errore Mortale
Il più grande disastro SEO che puoi commettere è lasciare per sbaglio questa riga quando passi il sito da staging a produzione:
User-agent: *
Disallow: /
Questo comando dice a Google: “Vai via, non guardare nessuna pagina del mio sito”. Il tuo sito sparirà letteralmente dai motori di ricerca in pochi giorni.
2. Sitemap XML: La Mappa del Tesoro
Se il robots.txt dice ai bot dove non andare, la sitemap.xml è la mappa che suggerisce loro dove dovrebbero andare assolutamente. È un elenco di tutte le URL del tuo sito che vuoi veder comparire su Google. Una volta pronta, il posto giusto per sottoporla manualmente a Google (e monitorare eventuali errori di scansione) è la Google Search Console - ne parlo nel dettaglio nella mia guida pratica alla Search Console.
Cosa mettere (e cosa NON mettere) nella Sitemap
Uno degli errori più comuni è usare plugin o script che inseriscono qualsiasi pagina del sito nella sitemap. Sbagliatissimo. Nella tua sitemap devono esserci solo URL canoniche, indexabili e che restituiscono un codice di stato 200 (OK).
Non includere mai:
- Pagine con tag
noindex(es. la pagina “Grazie per averci contattato”). - Pagine di paginazione (es.
/blog/pagina-2). - URL che restituiscono errori 404 o che reindirizzano altrove (301).
Includere “spazzatura” nella sitemap fa perdere fiducia a Googlebot riguardo la qualità della tua mappa.
Un mito da ridimensionare: priority e changefreq
In passato, i file XML includevano valori come <priority>0.8</priority> e <changefreq>weekly</changefreq>. Una dritta importante: oggi Google dichiara apertamente di ignorare questi due campi, affidandosi ai propri algoritmi per capire quanto spesso aggiorni una pagina. L’unico attributo che Google guarda ancora con estremo interesse è il <lastmod> (la data di ultima modifica), a patto che sia accurato e non aggiornato artificialmente a ogni build.
Detto questo, su questo stesso sito continuo a valorizzare priority e changefreq pagina per pagina (la home a 1.0/settimanale, i servizi a 0.9/mensile, i singoli articoli del blog a 0.6/mensile, le pagine tag a 0.3). Non lo faccio per Google, ma perché costa zero mantenerli, restano utili come documentazione interna delle priorità del sito e alcuni altri motori o tool di monitoraggio SEO potrebbero comunque tenerne conto. Il lastmod, invece, lo calcolo dinamicamente dalla data di aggiornamento reale di ogni articolo - quello sì che ha peso agli occhi di Google.
L’anello di congiunzione
C’è una regola d’oro che molti ignorano: devi sempre dichiarare il link della tua sitemap alla fine del tuo robots.txt. È il modo più veloce per farla trovare ai motori di ricerca. Questo è, testualmente, il robots.txt in produzione su questo sito:
User-agent: *
Allow: /

Sitemap: https://www.leonardocastignani.it/sitemap-index.xml
Come lo gestisco in Astro
Nei framework tradizionali creare una sitemap dinamica può essere tedioso. Con Astro, il processo è automatizzato tramite l’integrazione ufficiale @astrojs/sitemap, configurata in astro.config.mjs. Un chiarimento importante, perché è un errore comune: l’integrazione non inietta automaticamente il link nel robots.txt - quel file resta statico e il collegamento va dichiarato a mano una volta sola, come nell’esempio sopra.
Quello che l’integrazione fa davvero, invece, è generare la sitemap a ogni build leggendo tutte le route esistenti e applicando le regole che le passo io. Questo è, semplificato, il cuore della configurazione reale di questo sito:
// astro.config.mjs
sitemap({
  // Esclude dalla sitemap le pagine tag marcate noindex (in questo caso "aggiornamenti")
  filter: (page) => !/\/blog\/tag\/aggiornamenti\/?/.test(new URL(page).pathname),
  serialize(item) {
    const { pathname } = new URL(item.url);
    // Assegna priority/changefreq diversi in base al tipo di pagina,
    // e recupera il lastmod reale di ogni articolo dal frontmatter
    return { ...item, ...getSitemapOverrides(pathname) };
  }
})
In pratica: la home ha priorità massima e cadenza settimanale, le pagine tag (a basso valore SEO) scendono a 0.3, e ogni articolo del blog riceve il proprio lastmod reale, calcolato dalla data updatedDate dichiarata nel frontmatter di ciascun post - non una data finta rigenerata a ogni deploy, un dettaglio che fa la differenza per la credibilità della sitemap agli occhi di Google.
Conclusione
Il tuo codice può essere immacolato, ma se non dai a Google le indicazioni corrette per navigarlo, il tuo traffico organico ne soffrirà. Configurare intenzionalmente (e non casualmente) il robots.txt e la sitemap.xml significa avere il pieno controllo su come il mondo scopre il tuo progetto - la stessa cura che dedico ai dati strutturati JSON-LD per rendere ogni pagina non solo scansionabile, ma davvero comprensibile ai motori di ricerca.
Domande Frequenti
Qual è la differenza tra sitemap.xml e robots.txt?
Il file robots.txt è il 'guardiano' del sito e dice ai crawler di Googlebot quali pagine o cartelle non devono scansionare. La sitemap.xml, invece, è una 'mappa' che suggerisce ai motori di ricerca quali sono le pagine più importanti da indicizzare. Sono complementari: uno filtra, l'altra guida.
Cosa non deve mai essere inserito in una Sitemap XML?
In una Sitemap XML non devono mai esserci pagine non canoniche, URL con tag noindex, pagine di paginazione o link che restituiscono errori (come i 404) o redirect (301). Su questo sito, ad esempio, escludo dalla sitemap le pagine tag marcate noindex tramite un semplice filtro nella configurazione di Astro.
Fornisci audit e ottimizzazione SEO Tecnica per aziende nelle Marche?
Sì. Dal mio studio a Civitanova Marche, offro servizi avanzati di SEO Tecnica per PMI e siti e-commerce, dall'ottimizzazione del Crawl Budget alla generazione dinamica di sitemap e JSON-LD.
Hai un progetto simile in mente?
Se questo articolo ti ha dato spunti utili, posso aiutarti a metterli in pratica sul tuo sito o progetto.
Richiedi un preventivo gratuito