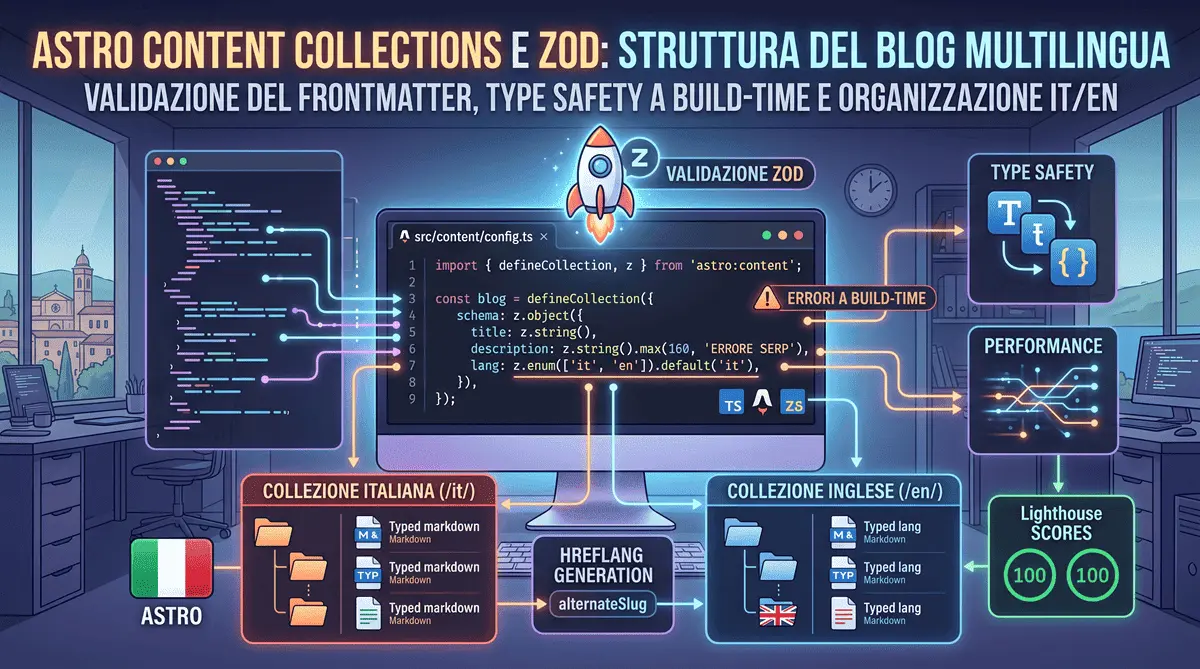
Astro Content Collections e Zod: Come Ho Strutturato Questo Blog Multilingua
Se stai leggendo questo articolo e navighi tra le sezioni del mio sito, stai usando una delle funzionalità più interessanti di Astro: le Content Collections. Ogni articolo che vedi è un file Markdown, e tra il file e la pagina c’è uno strato di validazione che decide cosa può andare online.
Fino a qualche anno fa, gestire un blog basato su file Markdown significava scoprire gli errori solo in produzione. Un campo scritto male nel frontmatter, una data mancante o una descrizione troppo lunga passavano in silenzio e finivano sulle pagine. Con le Content Collections, Astro valida ogni file contro uno schema Zod durante la build, e se qualcosa non va la build si ferma con un messaggio preciso.
Ecco come è organizzato davvero il blog che stai leggendo, con il codice reale del progetto e i suoi limiti onesti.
Lo schema reale: la “dogana” dei contenuti
Lo schema vive in src/content/config.ts. Questo è il file completo, senza semplificazioni:
// --- IMPORTS ---
import { defineCollection, z } from 'astro:content';

// --- BLOG COLLECTION DEFINITION ---
const blog = defineCollection({
    type: 'content',
    // --- SCHEMA DEFINITION WITH ZOD ---
    schema: z.object({
        title: z.string(),
        description: z.string().max(160, 'La meta description dovrebbe restare entro i 160 caratteri per evitare troncamenti in SERP.'),
        cardDescription: z.string().max(115, 'La card description deve restare corta per evitare troncamenti su mobile (line-clamp-3).'),
        pubDate: z.coerce.date(),
        updatedDate: z.coerce.date().optional(),
        heroImage: z.string().optional(),
        imageAlt: z.string().optional(),
        imageTitle: z.string().optional(),
        imageCaption: z.string().optional(),
        tags: z.array(z.string()).optional(),
        lang: z.enum(['it', 'en']).default('it'),
        alternateSlug: z.string().optional(),
        faqs: z.array(
            z.object({
                question: z.string(),
                answer: z.string(),
            })
        ).optional(),
    }),
});

// --- EXPORT COLLECTIONS ---
export const collections = { blog };
Alcune cose che è importante capire di questo schema, perché distinguono la realtà dalle buone intenzioni:
- I limiti che bloccano davvero la build sono due:
description(massimo 160 caratteri, il limite oltre cui Google tronca lo snippet) ecardDescription(massimo 115, per le card su mobile). Non è teoria: durante lo sviluppo di questo stesso blog, unacardDescriptionpiù lunga del limite ha fatto fallire il server con un erroreInvalidContentEntryDataError, esattamente come previsto. Il messaggio di errore riporta il file e il campo, quindi la correzione richiede pochi secondi. - Il titolo non ha alcun limite di lunghezza. Non l’ho imposto perché un titolo più lungo non rompe nulla di tecnico: il controllo di lunghezza, nel caso dei titoli, sarebbe una scelta editoriale, non uno vincolo del sistema.
- L’immagine di copertina è opzionale.
heroImagenon blocca la build se manca: l’articolo viene pubblicato comunque, e il layout gestisce l’assenza dell’immagine. - I tag sono solo stringhe.
tags: z.array(z.string())accetta qualunque valore: lo schema non verifica che il tag esista nel registro ufficiale. Il vocabolario controllato vive insrc/data/tags.tse viene usato per le etichette leggibili, con un fallback sulla chiave grezza se il tag non è registrato. È un limite che dichiaro apertamente: un refuso in un tag non blocca la build, lo rivelerebbe solo il risultato in pagina. Vincolare i tag con unz.enumsul registro sarebbe il passo successivo naturale.
Organizzazione multi-lingua: una collezione, due lingue
Invece di separare le collezioni per lingua, uso un’unica collezione blog con i file divisi in due cartelle:
src/content/blog/
├── it/
│   ├── astro-content-collections-zod-blog-multilingua.md
│   └── sicurezza-siti-web-csp-astro-marche.md
└── en/
    ├── astro-content-collections-zod-multilingual-blog.md
    └── website-security-csp-astro-guide-italy.md
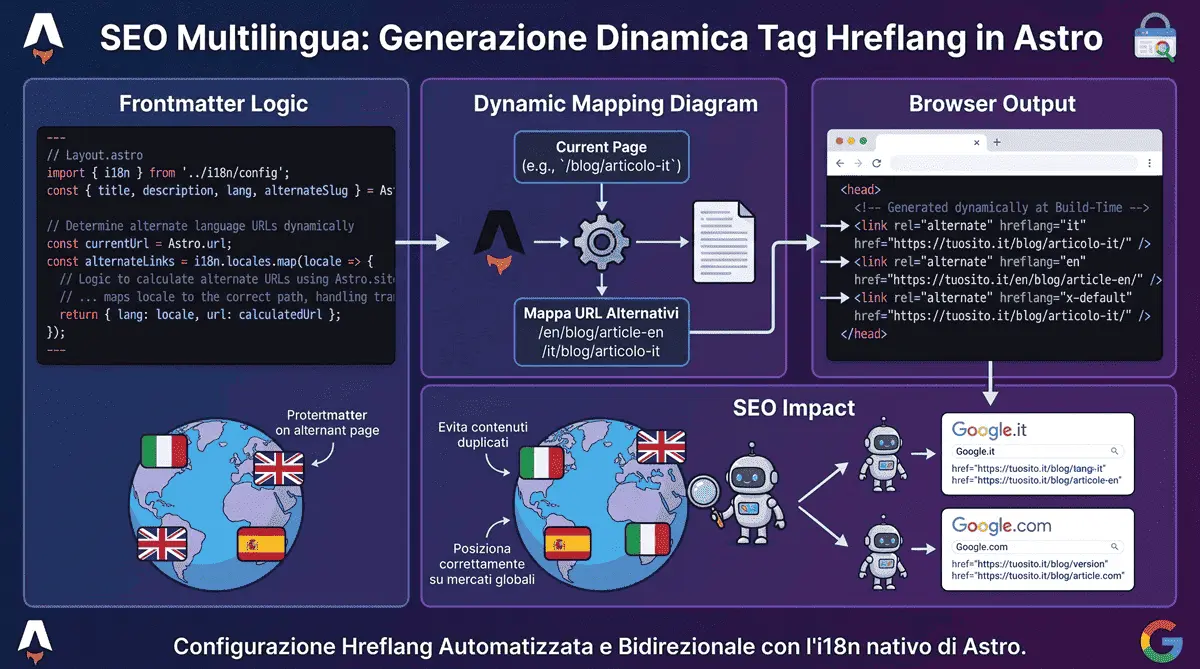
La lingua di un articolo non è decisa dalla cartella ma dal campo lang nel frontmatter, validato dallo schema come 'it' o 'en', con 'it' come valore predefinito. Il legame tra le due versioni di uno stesso articolo è il campo alternateSlug: ogni articolo indica lo slug della sua traduzione, e il layout lo usa per generare i tag hreflang e il selettore di lingua nell’header - un meccanismo che ho descritto nel dettaglio nel mio articolo su hreflang e SEO multilingua.
Un dettaglio pratico che incontri subito: lo slug generato da Astro include la cartella, quindi diventa it/nome-articolo. È per questo che nel codice reale trovi sempre una riga come post.slug.replace(/^it\//, '') prima di costruire un link.
Interrogare la collezione
Il codice reale della pagina che elenca gli articoli in italiano (src/pages/blog/index.astro) filtra per lingua e ordina per data decrescente:
const posts = (await getCollection('blog', ({ data }) => data.lang === 'it')).sort(
    (a: CollectionEntry<'blog'>, b: CollectionEntry<'blog'>) => b.data.pubDate.valueOf() - a.data.pubDate.valueOf()
);
Lo stesso schema di filtro alimenta il widget degli ultimi tre articoli in home (LatestPosts.astro, con .slice(0, 3)) e gli articoli correlati in fondo a ogni post (RelatedPosts.astro). Il vantaggio è che la logica di selezione è in un solo posto e i campi sono tipizzati: TypeScript conosce pubDate come Date perché lo schema lo dichiara con z.coerce.date().
Cosa mi ha insegnato costruirlo
Un blog così non è “solo testo online”. La validazione a build-time fa emergere gli errori prima della pubblicazione, il filtro per lingua tiene le due versioni separate ma collegate, e i limiti sui campi SEO sono applicati dal sistema invece che affidati alla memoria. Il limite più utile da ricordare è però quello che lo schema non controlla, come i tag: una validazione è affidabile solo quanto è completa, e capire dove si ferma è parte del lavoro.
Se vuoi vedere come queste scelte si collegano al resto del sito, parti dalla guida alla sitemap XML e robots.txt: la sitemap legge proprio il campo updatedDate di ogni articolo per calcolare il lastmod.
Domande Frequenti
Cosa sono le Content Collections in Astro e a cosa servono?
Le Content Collections sono una funzionalità nativa di Astro per organizzare, interrogare e tipizzare i contenuti locali, come i file Markdown. Sostituiscono il vecchio approccio basato su Astro.glob(), offrendo un'API più robusta e integrata con TypeScript.
Perché validare il frontmatter dei file Markdown con Zod in Astro?
Zod controlla il frontmatter di ogni file durante la build: se un articolo supera un limite o ha un campo sbagliato, Astro blocca la compilazione e segnala l'errore. È così che il mio blog impedisce, ad esempio, che una cardDescription più lunga di 115 caratteri finisca in produzione con un testo troncato nelle card.
Sviluppi blog e architetture personalizzate in Astro per aziende nelle Marche?
Sì. Dal mio studio di Civitanova Marche sviluppo piattaforme web con Astro, dalla gestione multi-lingua nativa alle collezioni di contenuti tipizzate, per garantire alle PMI scalabilità e nessun debito tecnico sui contenuti.
Hai un progetto simile in mente?
Se questo articolo ti ha dato spunti utili, posso aiutarti a metterli in pratica sul tuo sito o progetto.
Richiedi un preventivo gratuito